أفضل أدوات الذكاء الاصطناعي للبرمجة: ماذا تنجز مقابل 20 دولارًا؟

اختيار أفضل أدوات الذكاء الاصطناعي للبرمجة يبدأ بسؤال عملي: ماذا سأُنجز بالميزانية التي أدفعها؟ فقد تشتري عشرين دولارًا اشتراكًا في بيئة تساعدك على تعديل مشروع كامل، أو رصيد API يعالج ملايين التوكنات. لكن عدد التوكنات وحده لا يخبرك كم ميزة ستعمل فعلًا، وكم ساعة ستقضيها في إصلاح الأخطاء.
ضمن مقارنة أفضل أدوات الذكاء الاصطناعي للبرمجة، نراجع Cursor وChatGPT مع Codex وGoogle Antigravity وDeepSeek وQwen من حيث التكلفة وطريقة العمل وملاءمة بناء تطبيقات الويب. ستجد أسعارًا موثقة حين أمكن التحقق منها، وحسابًا واضحًا لميزانية 20 دولارًا، ونموذجًا تقديريًا يساعدك على فهم تأثير أولوياتك في الاختيار.
تاريخ مراجعة المصادر: 25 سبتمبر 2026. الأسعار بالدولار الأمريكي وفق الصفحات المشار إليها، وقد تختلف بحسب المنطقة والضرائب وطريقة الفوترة. درجات التقييم في المثال أدناه افتراضات تحريرية، وليست نتائج اختبار أداء مستقل.
أفضل أدوات الذكاء الاصطناعي للبرمجة: أيها تختار؟
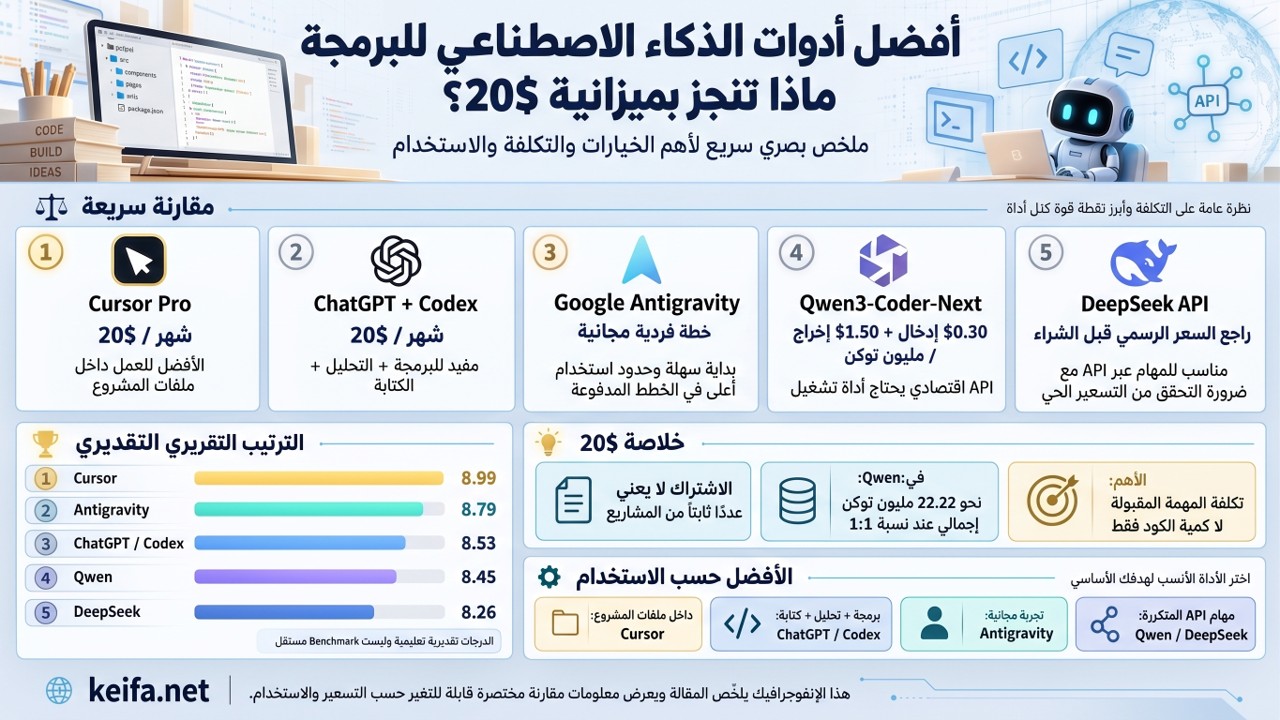
- تعمل يوميًا داخل ملفات مشروع: ضع Cursor ضمن أول خيارات التجربة، وقِس استهلاك الحصة على مهامك المعتادة.
- تجمع البرمجة والتحليل والكتابة في اشتراك واحد: قارن ChatGPT Plus مع Codex، بدل تقييم ChatGPT بوصفه نافذة محادثة فقط.
- تريد البداية دون اشتراك مدفوع: جرّب خطة Antigravity الفردية المجانية، مع مراعاة حدود الاستخدام.
- تنفّذ مهام آلية ومتكررة عبر API: افحص Qwen وDeepSeek باستخدام التكلفة الفعلية للمهمة ونسبة نجاحها.
قبل المقارنة: هذه الخيارات ليست كلها نماذج ذكاء اصطناعي
Cursor بيئة برمجة ووكلاء تستخدم نماذج مختلفة. وAntigravity منصة تطوير تعتمد على الوكلاء. أما ChatGPT فهو منتج متعدد الاستخدامات، وCodex تجربة مخصصة للعمل البرمجي. وDeepSeek وQwen اسمان لعائلات نماذج وخدمات يمكن الوصول إليها بطرق متعددة، منها API أو أدوات برمجية متوافقة.
لذلك تتأثر النتيجة بثلاث طبقات: النموذج، والأداة التي تشغّله، والمعلومات والصلاحيات المتاحة له. قد يؤدي نموذج واحد بصورة مختلفة عند استخدامه في محادثة تنسخ إليها الملفات يدويًا مقارنة بتشغيله داخل وكيل يستطيع قراءة المستودع وتشغيل الاختبارات. ولا يصح اعتبار انخفاض سعر API دليلًا على تفوق تجربة العمل كاملة.
مقارنة الأسعار وطريقة الاستخدام
| الخيار | التكلفة التي أمكن التحقق منها | ما الذي تقارنه عمليًا؟ |
|---|---|---|
| Cursor Pro | 20 دولارًا شهريًا | بيئة تطوير مع حصة لاستخدام النماذج والوكلاء؛ الاستخدام الإضافي قد يُحاسب منفصلًا |
| ChatGPT Plus مع Codex | 20 دولارًا شهريًا | اشتراك يشمل Codex؛ استهلاك الحصة يتأثر بالنموذج وتعقيد المهمة والسياق |
| Google Antigravity | خطة فردية مجانية؛ خطط Google AI المدفوعة تمنح حدودًا أعلى | تجربة وكلاء وحدود استخدام، وليس رصيدًا ثابتًا من التوكنات مقابل 20 دولارًا |
| Qwen3-Coder-Next عبر Model Studio | 0.30 دولار للإدخال و1.50 دولار للإخراج لكل مليون توكن، في الشريحة الدولية حتى 32K إدخال لكل طلب | فاتورة API متغيرة تحتاج إلى أداة تشغيل وإدارة للسياق |
| DeepSeek عبر API | يجب مراجعة سعر النموذج المحدد مباشرة قبل الشحن | لم يكتمل التحقق من جدول التسعير الحي أثناء إعداد المقالة؛ لذلك لا نعتمد هنا رقمًا حاليًا أو ترتيبًا سعريًا قاطعًا |
المصادر: أسعار Cursor، تسعير Codex وحدود الخطط، خطط Antigravity، أسعار Qwen3-Coder-Next. وللتحقق وقت الشراء، راجع صفحة تسعير DeepSeek الرسمية.
ماذا تشتري ميزانية 20 دولارًا فعلًا؟
في الاشتراكات: وقت عمل ضمن حصة متغيرة
اشتراك الأداة لا يساوي عددًا ثابتًا من التطبيقات أو الملفات. قراءة مشروع كبير، وتكرار المحاولات، وتشغيل مهام طويلة قد تستهلك الحصة أسرع من تعديل دالة قصيرة. وتصف OpenAI خطة Plus بأنها مناسبة لعدد من جلسات البرمجة المركزة أسبوعيًا، بينما توصي Cursor بخطة Pro+ لمستخدمي الوكلاء يوميًا. لهذا لا نفترض أن أي اشتراك أساسي يكفي تلقائيًا للعمل المكثف طوال اليوم.
في API: حساب التوكنات واضح، لكن الإنجاز يحتاج قياسًا
إذا كانت أسعار الإدخال والإخراج معروفة، يمكن حساب الاستهلاك مباشرة. التوكن وحدة لمعالجة النص وليست سطر كود أو كلمة ثابتة. ولحالة مبسطة تكون فيها كمية الإدخال مساوية لكمية الإخراج:
إجمالي ملايين التوكنات = 2 × الميزانية ÷ (سعر مليون الإدخال + سعر مليون الإخراج).
باستخدام أسعار Qwen المذكورة: 2 × 20 ÷ (0.30 + 1.50) = نحو 22.22 مليون توكن إجمالي، موزعة إلى 11.11 مليون إدخال و11.11 مليون إخراج. يفترض المثال بقاء كل طلب ضمن الشريحة السعرية المحددة، وعدم احتساب رسوم إضافية أو خصومات تخزين مؤقت. ومع نسبة إدخال إلى إخراج 4:1، تشتري الميزانية نظريًا نحو 29.63 مليون إدخال و7.41 مليون إخراج؛ لذلك يجب إعلان النسبة عند كل مقارنة.
تصحيح حسابي مهم: إذا افترضنا سعرًا قدره 0.15 دولار للإدخال و0.60 دولار للإخراج، فإن 20 دولارًا مع نسبة 1:1 تعطي 26.67 مليون توكن لكل جانب، أي 53.33 مليون إجمالي، لا 26.67 مليون إجمالي. هذا مثال لتوضيح الحساب، وليس اعتمادًا لسعر DeepSeek الحالي.
كمية الكود أم كمية العمل المنجز؟

تخيّل أداتين: الأولى تنشئ عشر ميزات وتنجح أربع منها فقط، والثانية تنشئ ست ميزات وتنجح خمس. الأداة الثانية حققت نتيجة أفضل وفق هذا المعيار، رغم أنها أنتجت كودًا أقل. هذا مثال افتراضي، لكنه يوضح لماذا تكون تكلفة المهمة المقبولة أكثر فائدة من عدد الرسائل أو الأسطر.
احسب التكلفة بطريقتين: التكلفة النقدية المباشرة مقسومة على عدد المهام المقبولة، ثم التكلفة الاقتصادية التي تضيف قيمة وقت المراجعة والتصحيح. قد يكون نموذج API اقتصاديًا ممتازًا إذا كانت مخرجاته مستقرة على مهامك؛ وقد تختفي هذه الميزة إذا اضطررت إلى إعادة بناء الحل يدويًا. ولا يمكن ترتيب أفضل أدوات الذكاء الاصطناعي للبرمجة ترتيبًا موثوقًا في الإنتاجية دون تنفيذ المهام نفسها عليها.
منحنيات Best Fit: كيف تغيّر أولوياتك النتيجة؟
الخطوط التي تصل درجات على معايير منفصلة ليست «منحنيات أفضل ملاءمة» إحصائية. فالملاءمة الإحصائية تحتاج إلى مشاهدات فعلية ومتغيرات قابلة للقياس. الأنسب هنا هو نموذج قرار مرجّح وتحليل حساسية: نضع أوزانًا للأولويات، ثم نفحص كيف تتغير النتيجة عند تغييرها.
للتوضيح فقط، نستخدم الدرجات التحريرية الافتراضية التالية من 10. لم تُستخرج هذه الدرجات من تجربة موحدة؛ كما أن اختلاف أداة تشغيل Qwen أو DeepSeek وإعدادات Codex قد يغيّر التقييم جذريًا. الغرض تعليم طريقة الحساب، وليس إثبات أن أحدها أذكى أو أكثر إنتاجية.
| الخيار | قوة البرمجة 30% | حجم المعالجة مقابل المال 25% | فهم المشروع 20% | الاستقلالية 15% | سهولة الاستخدام 10% | النتيجة الافتراضية |
|---|---|---|---|---|---|---|
| Cursor | 9.3 | 7.8 | 9.8 | 9.5 | 9.2 | 8.99 |
| Antigravity | 9.0 | 8.2 | 9.1 | 9.2 | 8.7 | 8.79 |
| ChatGPT / Codex | 9.7 | 6.7 | 8.5 | 8.7 | 9.4 | 8.53 |
| Qwen | 8.9 | 9.6 | 7.4 | 7.5 | 7.7 | 8.45 |
| DeepSeek | 8.7 | 10.0 | 6.8 | 7.0 | 7.4 | 8.26 |
النتيجة = مجموع (درجة المعيار × وزنه). مثلًا: نتيجة Cursor = 9.3×0.30 + 7.8×0.25 + 9.8×0.20 + 9.5×0.15 + 9.2×0.10 = 8.985. فرق أجزاء من الدرجة هنا لا يمثل دقة قياس؛ إنه ناتج حسابي لمدخلات تقديرية.

في الرسم نغيّر وزن السعر، مع الحفاظ على النسب المتبادلة بين بقية المعايير. يتصدر Cursor عند وزن 25% في هذا المثال، ثم تتحسن مواقع Qwen وDeepSeek كلما أعطينا الحجم الخام أولوية أكبر. هذه النتيجة ناتجة عن افتراضات الجدول نفسه؛ لا يجوز استخدامها وحدها دليلًا على أفضلية منتج أو لتحويل 20 دولارًا إلى عدد مضمون من التطبيقات.
كيف تختبر أفضل أدوات الذكاء الاصطناعي للبرمجة؟
ابدأ بنسخة واحدة من مشروع صغير، واستخدم نسخة مستقلة لكل أداة. اختر خمس مهام: بناء واجهة عربية متجاوبة، إضافة تحقق للمدخلات، إصلاح خطأ موجود، كتابة اختبارات لحالات حدية، وإضافة ميزة تمس أكثر من ملف. ثبّت المتطلبات والوقت المسموح وسجّل النموذج والإعدادات وتاريخ التجربة.
- عرّف النجاح قبل البدء: متى تعتبر الميزة مكتملة؟ حدد نتائج قابلة للفحص بدل عبارة «اجعلها احترافية».
- احسب التدخل البشري: سجّل زمن كتابة التوضيحات ومراجعة التغييرات وإصلاحها.
- افحص السلوك: شغّل الاختبارات، وجرّب الهاتف، والمدخلات الفارغة، والقيم غير الصحيحة.
- اقرأ استهلاك الاستخدام: سجّل فاتورة API أو نسبة الحصة المتاحة التي استُهلكت. لا تحوّل نسبة الاشتراك إلى سعر توكن مفترض.
- كرّر المهام المتقاربة: لا تجعل محاولة واحدة سببًا للحكم النهائي، وسجّل حالات الفشل أيضًا.
إذا كنت تبني حاسبة أو محول وحدات، افصل صحة المعادلات عن جمال الواجهة. واجهة ممتازة لا تعوّض خطأ في التحويل أو التقريب. ويمكن استلهام نوعية المشكلات الصغيرة التي تخدم المستخدم من أدوات كيف، ثم إنشاء حالات اختبار بمدخلات ونتائج متوقعة قبل طلب التنفيذ.
برومبت موحد لتجربة أدوات البرمجة
افحص المشروع وحدد الملفات المرتبطة بالمهمة. أضف واجهة عربية متجاوبة للحاسبة المحددة مع التحقق من المدخلات، واستخدم المعادلات وحالات الاختبار المرفقة. اذكر الافتراضات قبل التنفيذ، ونفّذ التغييرات الضرورية، ثم شغّل الاختبارات المتاحة. في النهاية لخّص الملفات المعدلة ونتائج الاختبارات وأي سلوك لم تستطع التحقق منه. لا تعتبر نجاح البناء وحده دليلًا على صحة الحسابات.
هل الجمع بين Cursor ونموذج API اقتصادي فكرة جيدة؟
قد يكون توزيع العمل بين أداة لإدارة المشروع ونموذج اقتصادي للمهام المتكررة مفيدًا، لكن لا توجد وفورات مضمونة. تحقّق أولًا من دعم المزود والنموذج داخل الأداة، وطريقة احتساب الاستخدام، وتوفر الميزات المطلوبة عند استخدام مفتاحك الخاص. ولا تفترض أن كل مزود متوافق مع صيغة API معينة يعمل تلقائيًا في كل وضع داخل Cursor.
لاختيار أفضل أدوات الذكاء الاصطناعي للبرمجة بميزانية محدودة، جرّب أداة واحدة على مشروع فعلي، ثم أضف الثانية عند ظهور حاجة واضحة: بلوغ حدود الاستخدام، أو تكرار مهام يمكن أتمتتها، أو انخفاض تكلفة مهمة ثبت نجاح النموذج الأرخص فيها. الاشتراكات المتعددة قبل قياس الاستخدام قد ترفع المصروف دون زيادة مقابلة في الإنجاز.
أفضل أدوات الذكاء الاصطناعي للبرمجة حسب نوع المشروع
تختلف المهارات المطلوبة لبناء صفحة تعريفية عن المهارات اللازمة لإصلاح تطبيق قائم. لهذا تساعدك السيناريوهات التالية على تحويل المقارنة العامة إلى قرار يمكنك اختباره، دون افتراض تفوق ثابت لمنتج بعينه. اختر السيناريو الأقرب لعملك، ودوّن ما تحتاج إلى تسليمه في نهايته، ثم امنح كل أداة المعلومات نفسها. لا توسّع المهمة أثناء تجربة أحد الخيارات وحده، لأنك عندها ستقارن متطلبات مختلفة وتخرج بانطباع مضلل.
السيناريو الأول: صفحة عربية أو حاسبة بسيطة
إذا كان مشروعك صفحة هبوط أو أداة حسابية صغيرة، فابدأ بتحديد المدخلات والمخرجات وطريقة العرض على الهاتف. اطلب واجهة تدعم اتجاه الكتابة من اليمين إلى اليسار، ورسائل خطأ مفهومة، وأمثلة جاهزة للتجربة. تشمل معايير القبول عدم اختفاء الأزرار عند تصغير الشاشة، وإمكانية استخدام لوحة المفاتيح، ووضوح وحدات القياس. وفي الحاسبات، قدّم النتائج الصحيحة لعدة حالات، حتى لا يصبح النموذج هو من يختار المعادلة ويقيّم صحتها في الوقت نفسه.
في هذا السيناريو، قيّم أفضل أدوات الذكاء الاصطناعي للبرمجة وفق جودة النسخة القابلة للاستخدام وسرعة تعديلها. لا تمنح نقاطًا إضافية لمجرد استخدام مكتبات أكثر أو إنتاج عدد أكبر من الملفات. الحل البسيط الذي يمكنك فهمه وتحديثه قد يكون أنسب لموقع محتوى من تطبيق يتطلب سلسلة طويلة من الخدمات. أعد التجربة بطلب تغيير محدود في التصميم، وسجّل هل حافظت الأداة على الوظائف السابقة أم أعادت كتابة أجزاء سليمة بلا ضرورة.
السيناريو الثاني: إصلاح مشروع متعدد الملفات
في مشروع قائم، جهّز وصفًا للخطأ وخطوات تكراره والنتيجة المتوقعة. اطلب من الأداة تحديد السبب، وشرح الملفات التي سيشملها التعديل، ثم إضافة اختبار يمنع عودة المشكلة. راقب هل تستخدم البنية الحالية وتحترم أسماء الوظائف والواجهات، أم تقترح إعادة بناء واسعة لا تتناسب مع حجم الخلل. والأهم أن تتحقق من الوظائف المجاورة؛ فقد يبدو الإصلاح ناجحًا على الشاشة بينما يغيّر سلوكًا تحتاج إليه في موضع آخر.
عند اختبار أفضل أدوات الذكاء الاصطناعي للبرمجة على هذا النوع من العمل، يصبح عدد مرات التصحيح وزمن فهم المشروع معيارين مهمين. سجّل الوقت حتى الوصول إلى أول تفسير صحيح، ثم الوقت حتى اجتياز الاختبارات. وإذا كانت الأداة غير قادرة على تشغيل المشروع في بيئتها، سجّل هذا القيد بوضوح. قد تظل مخرجاتها مفيدة، لكنك تحتاج إلى إدخال وقت التحقق اليدوي في المقارنة الاقتصادية.
السيناريو الثالث: مهام آلية متكررة عبر API
لنفترض أنك تريد تصنيف طلبات دعم أو إنشاء اختبارات لوظائف متشابهة أو تحويل ملفات إلى بنية موحدة. استخدم عينة صغيرة تمثل الحالات السهلة والصعبة قبل تشغيل المهمة على جميع البيانات. حدّد شكل المخرجات المطلوب، وكيفية اكتشاف المخرجات غير الصالحة، وعدد المحاولات المسموح. احسب تكلفة المحاولة الفاشلة أيضًا، وأوقف التشغيل عند تجاوز ميزانية التجربة. بهذه الطريقة تقارن دورة العمل كاملة بدل الاعتماد على سعر المليون توكن وحده.
هنا تتحدد أفضل أدوات الذكاء الاصطناعي للبرمجة والأتمتة بمدى انتظام النتائج وسهولة دمجها في برنامجك. اختبر الالتزام بالبنية المطلوبة، وطريقة التعامل مع المدخلات الناقصة، وقدرتك على تسجيل الأخطاء وإعادة المهام المتعثرة فقط. لا تنقل رصيد التجربة كله إلى دفعة كبيرة قبل أن تعرف التكلفة المتوسطة وتفاوتها. فقد تكون معظم الطلبات رخيصة، بينما تستهلك مجموعة صغيرة معقدة جزءًا كبيرًا من الميزانية.
مثال حسابي لتكلفة المهمة المقبولة
لتطبيق معيار الإنجاز، افترض تجربة تضم عشر مهام متساوية المتطلبات. أنفق الخيار الأول دولارين على الاستدعاءات ونجح في ثماني مهام، بينما أنفق الثاني أربعة دولارات ونجح في التسع. التكلفة النقدية لكل مهمة مقبولة تساوي 0.25 دولار للأول ونحو 0.44 دولار للثاني. هذه أرقام افتراضية لتوضيح الحساب، وليست نتائج لأي منتج في الجدول. ولا يصح وضع المهام الناجحة فقط في حساب المصروف؛ لأن الاستدعاءات الفاشلة دفعتها بالفعل.
أضف الآن وقت المراجعة: احتاج الخيار الأول إلى ساعتين من العمل اليدوي، والثاني إلى نصف ساعة. إذا افترضت قيمة 10 دولارات لساعة عملك، تصبح التكلفة الاقتصادية 22 دولارًا للأول و9 دولارات للثاني. وبعد القسمة على المهام المقبولة، تكون النتيجة 2.75 دولار مقابل دولار واحد. يوضح المثال كيف يتغير القرار عندما يكون وقتك محدودًا، مع بقاء تقييم قيمة الساعة قرارًا شخصيًا وليس سعرًا ملزمًا.
لهذا، عند مقارنة أفضل أدوات الذكاء الاصطناعي للبرمجة، احتفظ بنتيجتين منفصلتين: الأرخص نقديًا والأقل استهلاكًا لوقتك. الطالب الذي يريد التعلم قد يقبل تدخلًا أطول، بينما يحتاج صاحب موقع إلى تحديث سريع يمكن الاعتماد عليه. وفي الاشتراكات الشهرية، استخدم مصروف الاشتراك الفعلي خلال الفترة وعدد المهام المقبولة فيها. لا توزّع التكلفة على عدد متفائل من المهام لم تنفذها؛ فهذا يجعل العرض يبدو اقتصاديًا أكثر مما تثبته تجربتك.
أخطاء شائعة عند مقارنة أدوات البرمجة
أول خطأ هو تغيير النموذج والإعدادات دون تسجيل ذلك. إذا جرّبت نموذجًا سريعًا في منتج ونموذجًا أبطأ وأعلى تكلفة في آخر، فدوّن الفرق بدل نسب النتيجة إلى اسم التطبيق فقط. والخطأ الثاني مقارنة طلب قصير بآخر يتضمن ملفات وأمثلة وقيودًا واضحة. جودة التعليمات جزء من التجربة، ولذلك يجب أن تتلقى الأدوات وصفًا متكافئًا. كذلك، لا تستخدم مشروعًا نجحت أداة في تعديله كنقطة بداية للأداة التالية.
الخطأ الثالث اعتبار المظهر الجميل دليلًا على اكتمال المشروع. جرّب مسارات الاستخدام الفعلية من البداية إلى النهاية: إدخال البيانات وحفظها واستعادتها والتعامل مع الخطأ. والخطأ الرابع إهمال قابلية الصيانة؛ افتح الملفات واسأل هل تستطيع معرفة مكان تعديل نص أو معادلة أو لون بعد أسبوع؟ اختيار أفضل أدوات الذكاء الاصطناعي للبرمجة يتأثر بسهولة متابعة العمل لاحقًا، خصوصًا عندما تكون أنت المسؤول عن الموقع دون فريق تقني كامل.
الخطأ الخامس دفع اشتراكات متعددة قبل معرفة موضع التعطل. قد تكون المشكلة في متطلبات غامضة أو مشروع يصعب تشغيله، وعندها لن يحل الاشتراك الأعلى المشكلة وحده. اكتب تعليمات تشغيل قصيرة، وحدد الملفات الأساسية، وأرفق رسالة الخطأ كاملة بعد إزالة البيانات الخاصة. واطلب من الوكيل تلخيص ما تحقق منه فعلًا. الإجابة التي تصرّح بأن اختبارًا لم يُشغّل تمنحك معلومة عملية أفضل من إعلان نجاح لا يرافقه دليل.
خطة أسبوعية لتجربة أفضل أدوات الذكاء الاصطناعي للبرمجة
خصص اليوم الأول لتجهيز المشروع ومعايير النجاح، واليوم الثاني لتجربة ميزة صغيرة في الخيارات المتاحة لك. في اليوم الثالث اختبر إصلاح خطأ، وفي الرابع نفّذ تغييرًا يمتد إلى أكثر من ملف. اجعل اليوم الخامس للمراجعة: شغّل النسخ وقارن النتائج وسجّل الوقت والمصروف. لا يلزم شراء جميع الخطط لإجراء هذه البداية؛ استخدم ما تملكه وما تتيحه الخطط التجريبية، واعتبر غياب الوصول إلى خيار معين قيدًا في المقارنة.
في اليوم السادس جرّب تعديلًا جديدًا على النسخة السابقة لاختبار استمرارية العمل. وفي اليوم السابع راجع السجل واختر المنتج الذي اجتاز المتطلبات ضمن وقتك وميزانيتك. احتفظ بأسباب الاختيار، مثل انخفاض مرات التدخل أو وضوح التعديلات أو القدرة على تشغيل الاختبارات. بهذه الخطوات تتحول قائمة أفضل أدوات الذكاء الاصطناعي للبرمجة إلى قرار خاص بمشروعك يمكن مراجعته، بدل أن يبقى القرار تابعًا لترتيب عام أو انطباع عن إجابة واحدة.
أسئلة شائعة عن أفضل أدوات الذكاء الاصطناعي للبرمجة
هل Cursor أفضل من ChatGPT للبرمجة؟
يتوقف ذلك على تجربة العمل والنموذج والمهمة. إذا كان عملك داخل محرر وملفات كثيرة، جرّب Cursor على سير عملك. وعند المقارنة مع OpenAI استخدم Codex في وضع مناسب للمشروع، حتى لا تقارن وكيلًا متكاملًا بمحادثة تنقل إليها الكود يدويًا.
من ينجز أكبر كمية عمل مقابل 20 دولارًا؟
لا يمكن إعطاء ترتيب موثوق دون تجربة موحدة. يمكن حساب كمية API عندما نعرف الأسعار ونسبة الإدخال والإخراج، لكن قياس الإنجاز يتطلب حساب المهام المقبولة ووقت التصحيح وحدود الحصة.
هل Antigravity مجاني بالكامل؟
توجد خطة فردية بسعر صفر دولار مع حدود استخدام أساسية. وجود خطة مجانية لا يعني أن تشغيل الوكلاء والنماذج متاح بلا حدود، وتمنح خطط Google AI المدفوعة حدودًا أعلى وفق شروطها.
هل اشتراك ChatGPT Plus يتضمن رصيد API؟
استخدام Codex ضمن الاشتراك يختلف عن تشغيله بمفتاح API، الذي تُحسب تكلفته وفق تسعير API. لا تتعامل مع قيمة الاشتراك باعتبارها رصيدًا يمكن إنفاقه على الاستدعاءات البرمجية.
اختيار أفضل أدوات الذكاء الاصطناعي للبرمجة حسب احتياجك
لعمل يومي داخل مشروع متعدد الملفات، ابدأ بمقارنة Cursor وCodex على المهمة نفسها. ولتجربة دون اشتراك مدفوع، اختبر Antigravity ضمن حدوده. وللأتمتة والاستهلاك المتكرر، احسب تكلفة Qwen وDeepSeek بعد تثبيت النموذج والسعر ونسبة النجاح. المنتج الأنسب هو الذي يقلّل تكلفة الوصول إلى نتيجة صحيحة يمكنك استخدامها؛ وقد تختلف إجابته بين واجهة بسيطة ومشروع كبير وأداة حسابية تحتاج تدقيقًا.


